CASE STUDY / LOCAL AI SYSTEM
ObsAgent CLI
01 / PRODUCT BRIEF
为什么本地知识库 AI 不应该只是一个聊天框
普通全文搜索难以回答跨文档问题,而直接把整个 Vault 上传给远程模型又会带来隐私、成本和上下文失控风险。ObsAgent CLI 的目标不是增加一个聊天框,而是把解析、索引、检索、证据引用和文件写入组织成一条本地优先、可验证、可恢复的工作流。
- 让 Obsidian Markdown 文件继续作为唯一事实来源,索引可以随时重建
- 通过 FTS5、向量和图关系检索,减少单一检索策略的盲区
- 让回答绑定到有限证据,并在证据不足或引用无效时拒答
- 让 Agent 的执行步数、工具调用和错误次数处于可控范围
- 让任何文件修改都经过预览、人工批准、并发校验和可恢复事务
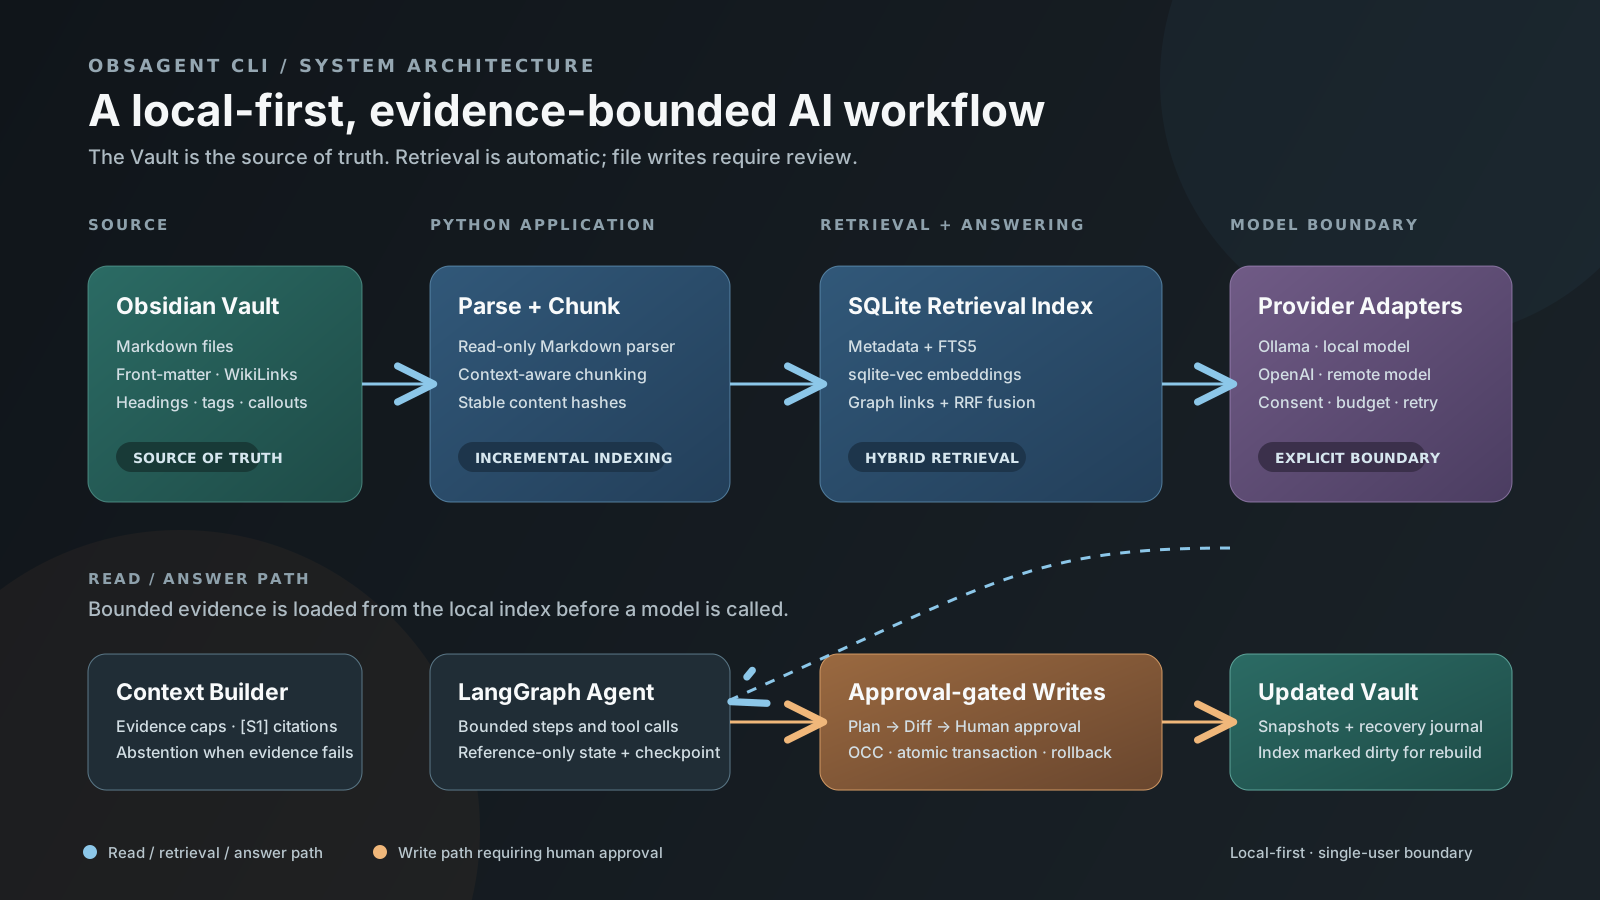
02 / SYSTEM FLOW
一次问答和一次文件修改如何完成
- 01
Parse
Scanner 以只读方式读取 Vault,解析 Front-matter、标题、段落、代码块、Callout、WikiLink 和标签,不执行 Markdown 中的 HTML、JavaScript 或 Dataview。
- 02
Index
Context-aware Chunker 按标题层级和段落边界生成带 breadcrumb 的分块,再写入 SQLite 元数据、FTS5 索引和 sqlite-vec 向量索引;内容 Hash 用于增量更新和文件移动识别。
- 03
Retrieve
搜索请求可以走关键词、向量或图检索;Hybrid 模式使用 RRF 合并结果,并在语义能力不可用时明确降级为关键词检索。
- 04
Answer
ContextBuilder 从 SQLite 加载原始内容,限制证据数量、上下文和输出规模,为片段标注 [S1] 等引用,再由校验器检查引用是否确实来自检索证据。
- 05
Approve
Agent 的写操作先生成 ChangeSet 和 Diff,暂停等待明确的人类批准;通过路径校验、原始 Hash 校验和事务日志后才替换 Vault 文件。
03 / ENGINEERING DECISIONS
代码中真实存在的 AI 工程设计
- 01
让 Vault 成为唯一事实来源
实现Markdown 文件是最终数据,SQLite、FTS5 和 sqlite-vec 都是可以删除并重建的派生索引。增量索引通过内容 Hash 跳过未变化文件,并识别唯一的移动或重命名。
价值降低索引损坏和数据迁移风险,也让系统可以围绕“源文件是否正确”而不是“数据库是否拥有全部内容”进行恢复设计。
- 02
用结构化分块保留 Markdown 语义
实现分块器保留标题 breadcrumb,并将代码块、Callout 和 Block ID 段落作为不可拆分单元,在段落边界切割并生成稳定的 raw_content 与 embedding_text。
价值避免固定长度切割破坏代码和说明之间的语义关系,同时为稳定的向量缓存、引用定位和增量更新提供基础。
- 03
用混合检索代替单一向量搜索
实现关键词检索使用 SQLite FTS5,语义检索使用 sqlite-vec,WikiLink 关系通过图检索补充,Hybrid 模式使用 RRF 融合多路排名。
价值精确术语、自然语言表达和文档关系各有适合的检索路径,并且不需要引入独立的向量数据库或外部搜索集群。
- 04
把回答限制在可验证证据内
实现回答流程不直接使用 FTS 摘要,而是回读原始内容,统一限制 evidence、context 和 output,并对模型引用进行校验和修复;没有可靠证据时返回 abstention。
价值把“模型说得像真的”转化为可检查的证据链,降低上下文污染、引用幻觉和无依据回答的风险。
- 05
用有界 LangGraph Agent 管理工具调用
实现Agent 通过确定性的 intent route 选择搜索或规划路径,限制最大步骤、重复工具调用、连续错误和无进展次数;状态只保存引用和 Artifact,而不是不断复制大段内容。
价值Agent 的行为可预测、可恢复、可审计,更适合本地文件操作,而不是依赖模型自行决定何时停止。
- 06
把文件写入设计成审批后的事务
实现safe_write 校验 Vault 相对路径、保留目录和符号链接;事务服务保存快照并执行 OCC 原始 Hash 检查,写入失败时可以回滚或通过恢复日志继续处理。
价值即使 Agent 生成了错误计划,也不会直接覆盖用户文件;写入过程具备预览、冲突检测和恢复入口。
04 / CURRENT BOUNDARIES
当前实现的能力边界
项目已经把本地检索、证据约束和安全写入串成完整闭环,但它仍是本地单用户系统,不能包装成云端多租户或生产级分布式 AI 平台。
- 高优先级
这是本地单用户系统,不是云端多租户平台
FastAPI、React UI 和 Agent Runtime 都围绕本机 Vault 运行,当前没有账号体系、跨用户隔离、云端同步或多实例任务调度。不能将其描述成 SaaS 型 AI 平台。
- 高优先级
远程模型能力仍受用户同意和网络影响
OpenAI Embedding 或 LLM 调用只在明确的 Consent 和预算约束下发送必要文本,但网络延迟、Provider 可用性和模型回答质量不包含在本地检索基准中。
- 中优先级
性能基准是合成本地基准,不是生产 SLA
项目文档记录了 10,000 篇笔记和 100,000 个分块的本地测试,但测试不包含远程网络和真实用户 Vault 分布,不能直接推导生产 QPS 或端到端延迟。
- 中优先级
重排序和评测体系仍较基础
当前提供 Reranker 接口,但主要实现是 NoOpReranker;项目也需要真实 Vault 评测集来验证召回、引用正确率和拒答质量,而不仅是检索延迟。
- 中优先级
本地威胁模型不覆盖恶意同用户进程
项目重点防范 Agent 误写、路径穿越、符号链接和并发覆盖;如果另一个拥有同一用户文件权限的本地进程恶意修改文件,当前系统不承诺隔离。
05 / NEXT ITERATION
下一轮应该怎么做
- 01
使用真实 Obsidian Vault 构建检索、引用和拒答评测集,补充可重复的质量指标
- 02
增加精确 tokenizer 统计、Provider 延迟与成本观测,并区分本地和远程调用预算
- 03
实现更强的 Reranker 与可解释的检索诊断页面,帮助定位召回失败原因
- 04
补充多进程锁、故障恢复和文件外部修改场景的集成测试
- 05
在保持本地优先边界的前提下评估 Tauri 桌面封装,而不是直接引入云端多租户复杂度